
Collect Resets & Train RL Policy#
Reproduce our training results from scratch.
Tip
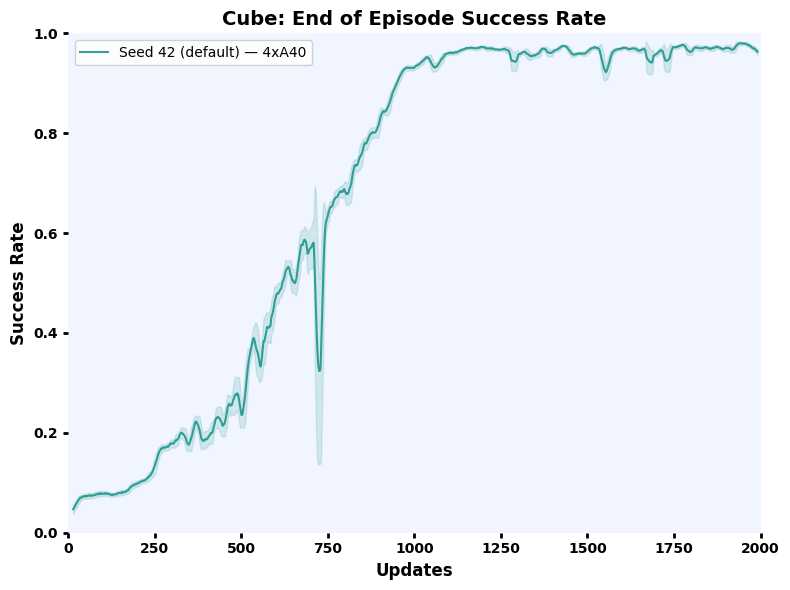
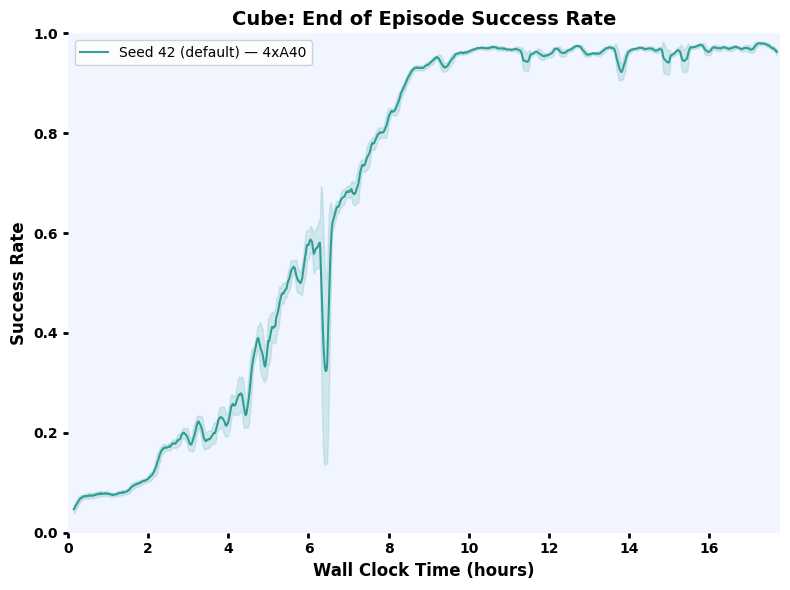
Want to try it quickly? Start with Cube Stacking or Peg Insertion. They have the fastest reset state collection times and converge within ~8 hours on 4×L40S GPUs.
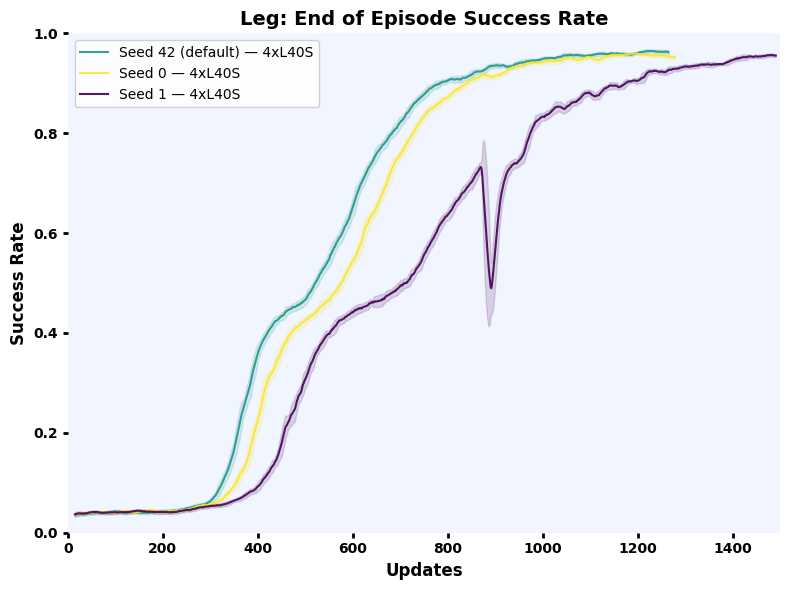
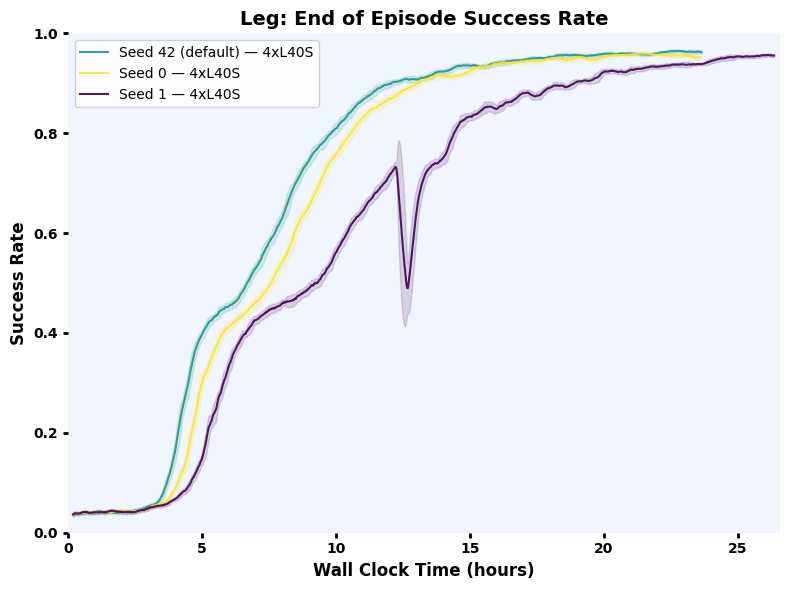
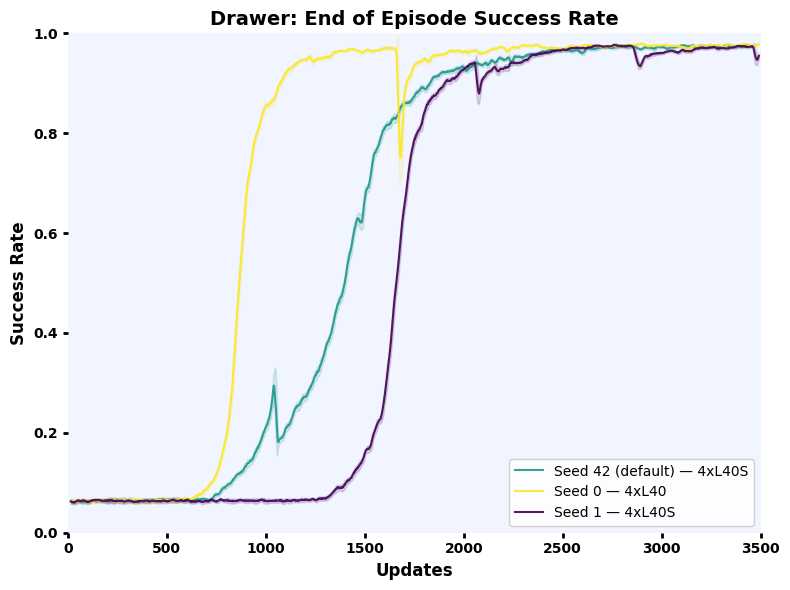
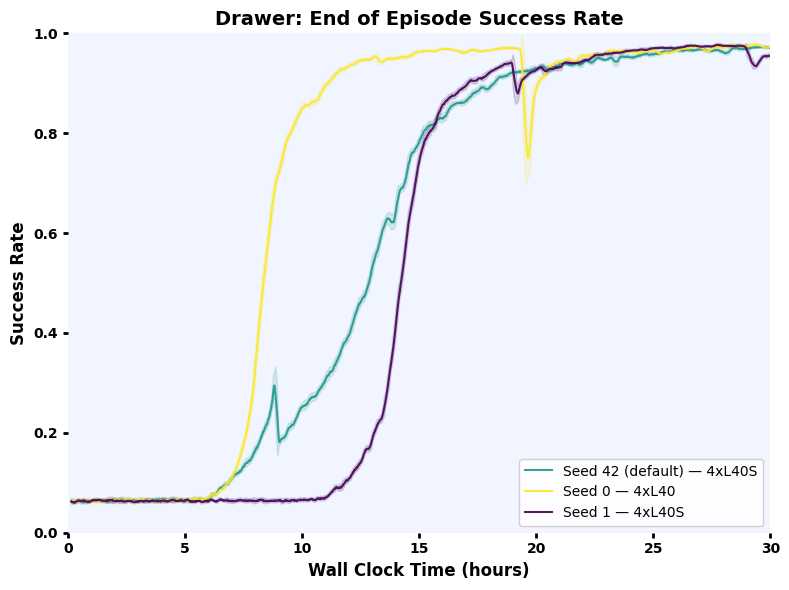
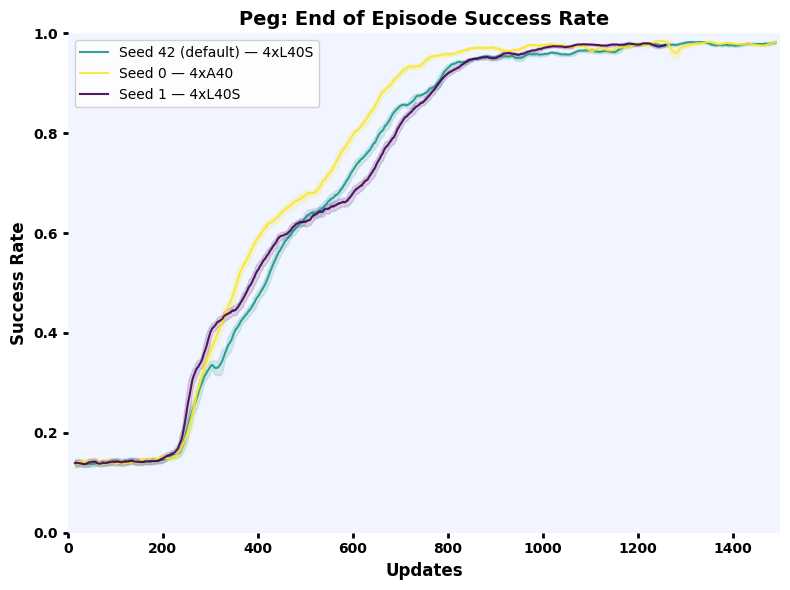
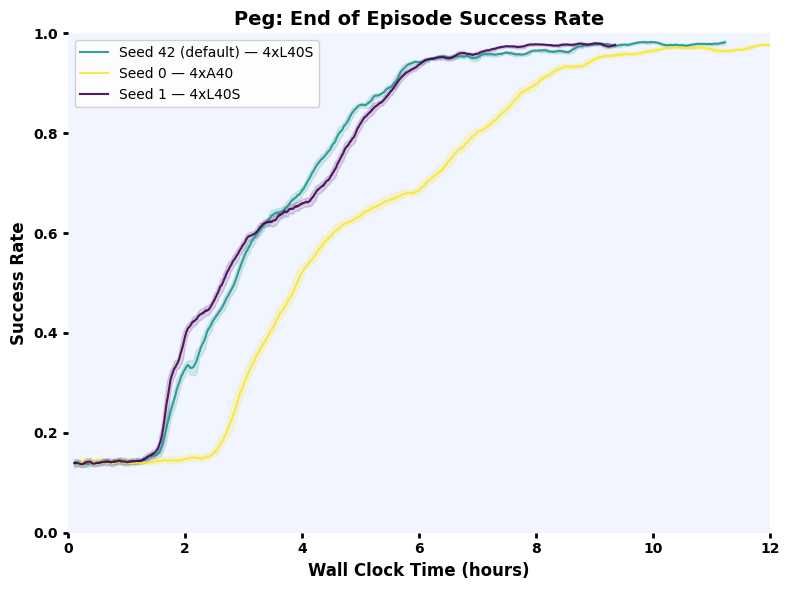
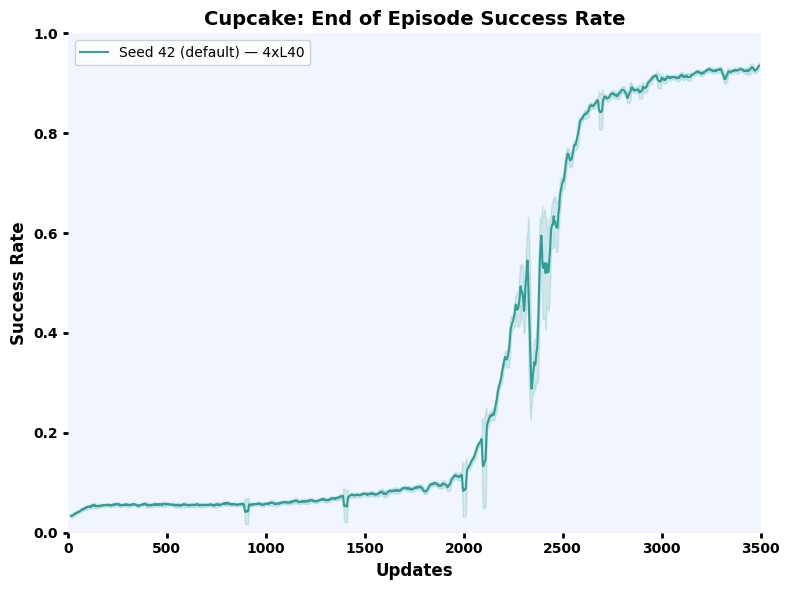
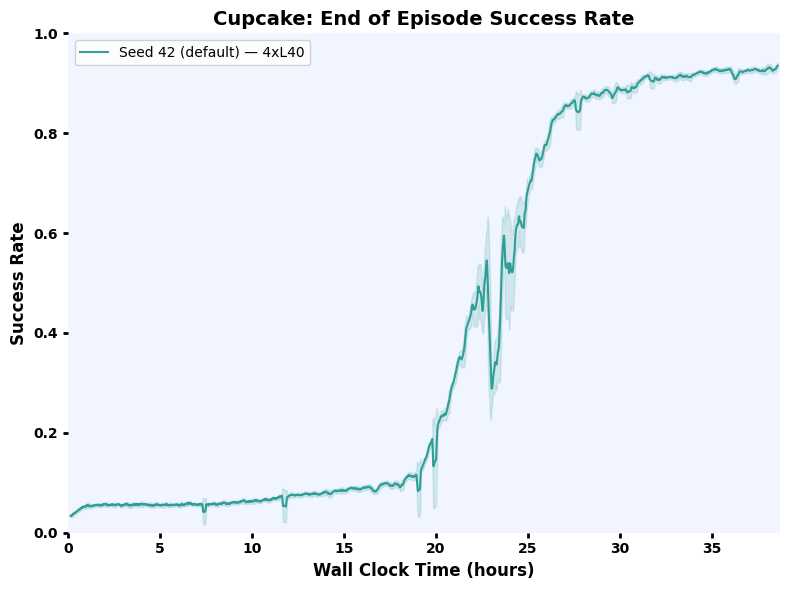
Plots show seeds 42, 43, and 44 on 4x L40S each. Relaunches are joined by PPO update; dotted links mark gaps without logged samples. The first 30 updates after a resume are omitted while the success window refills. Time sums the logged runtime of each run, not total elapsed wall-clock time.
Warning
Known performance regressions in Isaac Lab 3
Leg Twisting: Training success can drop sharply after roughly 24 hours. The current workaround is to restart training from a checkpoint saved before the drop, rather than from the latest degraded checkpoint. This is a workaround, not a resolved fix.
Rectangle on Wall: Performance has degraded significantly compared with the Isaac Lab 2 version. If you need this task now, use UWLab v1.2.0 with an Isaac Lab 2.x environment, rather than mixing that tag with the current Isaac Lab 3 installation.
If you have a fix for either issue, please open a pull request. We’ll review it.
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=fbleg
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=fbleg env.scene.receptive_object=fbtabletop
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=fbleg \
    env.scene.receptive_object=fbtabletop
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=fbleg \
    env.scene.receptive_object=fbtabletop \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
Shown through 22.5 logged hours, before the first seed drops.
|
|
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=fbdrawerbottom
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=fbdrawerbottom env.scene.receptive_object=fbdrawerbox
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=fbdrawerbottom \
    env.scene.receptive_object=fbdrawerbox
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=fbdrawerbottom \
    env.scene.receptive_object=fbdrawerbox \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
|
|
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=peg env.scene.receptive_object=peghole
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=peg
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=peg env.scene.receptive_object=peghole
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=peg \
    env.scene.receptive_object=peghole
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=peg \
    env.scene.receptive_object=peghole \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
|
|
Warning
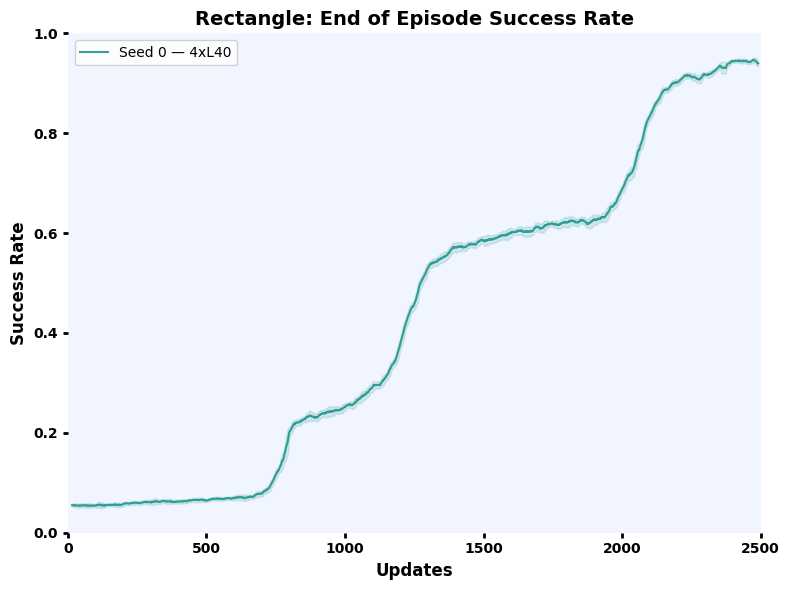
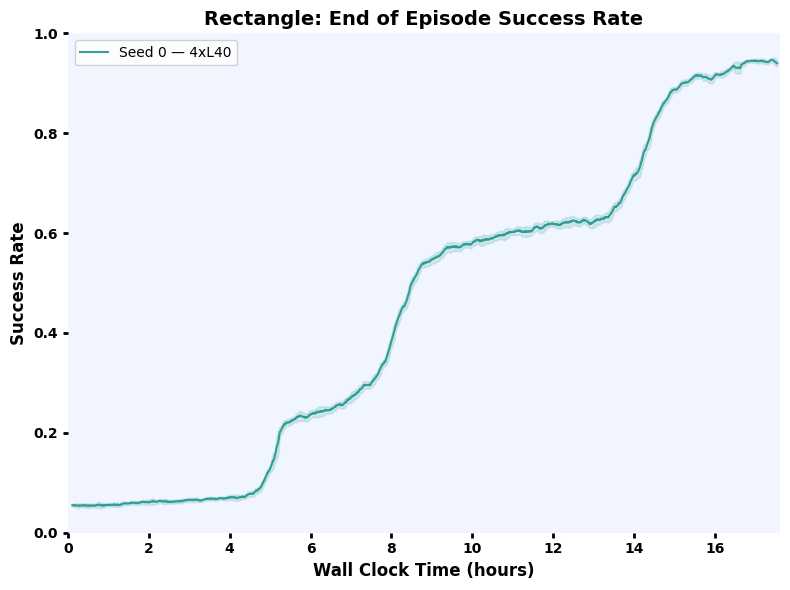
Isaac Lab 3 regression: Rectangle success stalls at 62-65%. For now, use UWLab v1.2.0 with Isaac Lab pinned to 2.x. Have a fix? Send a PR. We’ll take a look.
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=rectangle env.scene.receptive_object=wall
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=rectangle
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=rectangle env.scene.receptive_object=wall
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=rectangle \
    env.scene.receptive_object=wall
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=rectangle \
    env.scene.receptive_object=wall \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
|
|
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=cube env.scene.receptive_object=cube
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=cube
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cube env.scene.receptive_object=cube

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cube env.scene.receptive_object=cube \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cube env.scene.receptive_object=cube \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cube env.scene.receptive_object=cube \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=cube env.scene.receptive_object=cube
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=cube env.scene.receptive_object=cube
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=cube env.scene.receptive_object=cube
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=cube env.scene.receptive_object=cube
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=cube env.scene.receptive_object=cube
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=cube \
    env.scene.receptive_object=cube
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=cube \
    env.scene.receptive_object=cube \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
|
|
Note
Skip directly to Step 4 if you want to train an RL policy with our pre-generated reset state datasets. Only run Steps 1-3 if you want to generate your own.
Step 1: Collect Partial Assemblies (~30 seconds)
python scripts_v2/tools/record_partial_assemblies.py --task OmniReset-PartialAssemblies-v0 --num_envs 10 --num_trajectories 10 --visualizer none env.scene.insertive_object=cupcake env.scene.receptive_object=plate
Step 2: Sample Grasp Poses (~1 minute)
python scripts_v2/tools/record_grasps.py --task OmniReset-Robotiq2f85-GraspSampling-v0 --num_envs 8192 --num_grasps 1000 --visualizer none env.scene.object=cupcake
Step 3: Generate Reset State Datasets (~1 min to multiple hours depending on the reset and task)
# Object Anywhere, End-Effector Anywhere (Reaching)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEAnywhere-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate

# Object Resting, End-Effector Grasped (Near Object)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectRestingEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate \
    env.events.reset_insertive_object_pose_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Anywhere, End-Effector Grasped (Grasped)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectAnywhereEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3

# Object Partially Assembled, End-Effector Grasped (Near Goal)
python scripts_v2/tools/record_reset_states.py \
    --task OmniReset-UR5eRobotiq2f85-ObjectPartiallyAssembledEEGrasped-v0 \
    --num_envs 4096 --num_reset_states 10000 --visualizer none \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate \
    env.events.reset_insertive_object_pose_from_partial_assembly_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3 \
    env.events.reset_end_effector_pose_from_grasp_dataset.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Step 3.5: Visualize Reset States (Optional)
Visualize the generated reset states to verify they are correct. By default all four reset distributions are loaded; use the tabs below to visualize one at a time.
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEAnywhere \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectRestingEEGrasped \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectAnywhereEEGrasped \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate
python scripts_v2/tools/visualize_reset_states.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-Play-v0 \
    --num_envs 4 --dataset_dir ./Datasets/OmniReset_isaaclab3 \
    --reset_type ObjectPartiallyAssembledEEGrasped \
    env.scene.insertive_object=cupcake env.scene.receptive_object=plate
Step 4: Train RL Policy
Train with our pre-generated cloud datasets:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=cupcake \
    env.scene.receptive_object=plate
Or, train with your locally generated datasets from Steps 1-3:
python -m torch.distributed.run \
    --nnodes 1 \
    --nproc_per_node 4 \
    scripts/reinforcement_learning/rsl_rl/train.py \
    --task OmniReset-Ur5eRobotiq2f85-RelCartesianOSC-State-v0 \
    --num_envs 16384 \
    --logger wandb \
    --visualizer none \
    --distributed \
    env.scene.insertive_object=cupcake \
    env.scene.receptive_object=plate \
    env.events.reset_from_reset_states.params.dataset_dir=./Datasets/OmniReset_isaaclab3
Training Curves
|
|
Modifying RSL-RL#
If you want to modify the RSL-RL algorithm (e.g. custom loss functions, network architectures, or training loops), you can install a local editable copy. Clone it as a sibling of UWLab:
parent_dir/
├── UWLab/
└── rsl_rl/
git clone https://github.com/UW-Lab/rsl_rl.git
cd rsl_rl
pip uninstall rsl-rl-lib
pip install -e .
Any changes you make to the cloned rsl_rl/ directory will take effect immediately without reinstalling.
Next Steps#
With a trained policy, you can:
Go sim-to-real: Continue to Sim2Real: SysID & RL Finetuning to finetune with system identification.
RGB student-teacher distillation: See Distillation & Deployment for collecting RGB data with the state-based expert and training an RGB BC policy.